

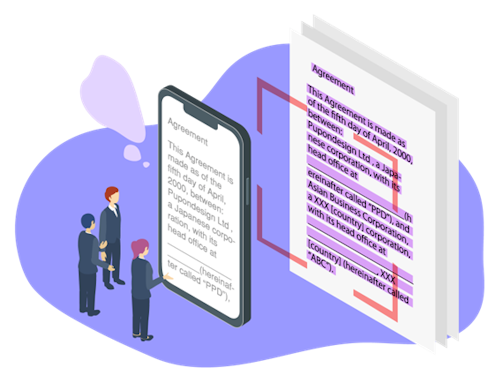
生成AIの活用が急速に広がり、ChatGPTやCopilotを使って社内文書の検索や要約を行う企業も増えています。
しかし、
- PDFをアップロードしたのに期待した回答が得られない
- AIが文書の内容を正しく理解してくれない
- 契約書やマニュアルを検索しても必要な情報が見つからない
といった課題に直面するケースも少なくありません。
「AIの性能が低いのでは?」と思われがちですが、実は原因の多くはAIそのものではなく、PDFの状態にあります。
本記事では、ChatGPTなどの生成AIが読めないPDFの特徴と、その課題を解決するOCRの重要性、さらにAdobe PDF LibraryのOCR機能を活用した自動処理について解説します。
ChatGPTで読めないPDFとは?
多くの人はPDFを見れば「文字が書かれている」と認識します。
しかしAIが見ているPDFの中身は、人間が見ているものとは異なります。
PDFには大きく分けて2種類あります。
テキストPDF
PDF内部に文字情報が保存されている状態です。
- 文字選択ができる
- キーワード検索ができる
- テキスト抽出ができる
このようなPDFは生成AIでも比較的扱いやすい文書です。
画像PDF
紙文書をスキャンしたPDFによく見られます。
見た目は文字に見えても、内部的には画像が貼り付けられているだけです。
例えば、
- スキャンした契約書
- 古い紙マニュアル
- 紙帳票の電子保管データ
- 手書き書類のPDF
などが該当します。
この状態ではAIは文字情報を取得できず、正確な検索や要約が難しくなります。
あなたのPDFはAIが読める?
簡単に確認する方法があります。
PDFを開いて、
- 文字をドラッグして選択できるか
- PDF内検索ができるか
を確認してみてください。
もし文字選択や検索ができない場合、そのPDFは画像PDFである可能性が高く、そのままではAI活用に適していない状態です。
AI活用を支えるOCRとは
そこで重要になるのがOCRです。
OCR(Optical Character Recognition)とは、画像内の文字を認識し、テキストデータへ変換する技術です。OCRを実施すると、単なる画像だったPDFが検索可能なPDFへ変わります。
OCR前
└─ 画像
└─ AIでは読み取りが困難
OCR後
├─ 画像
└─ テキスト情報
└─ AIが活用できる
となります。
つまり、生成AIが文書を正しく理解するための土台作りがOCRなのです。
OCRが重要になる理由
生成AIやRAG(検索拡張生成)の精度は、利用するデータの品質に大きく依存します。
どれだけ高性能なAIを導入しても、
- OCRされていないPDF
- 検索できないPDF
- テキスト抽出できないPDF
ばかりでは期待した成果は得られません。
実際、多くの企業では長年蓄積されたPDF資産の中に、
- 契約書
- 技術文書
- 設計資料
- 品質管理文書
- 紙の帳票
などの画像PDFが大量に存在しています。
これらをAI活用の対象にするためには、まずOCRによってテキスト化する必要があります。
Adobe PDF LibraryのOCR機能とは
Adobe PDF Libraryは、Adobe Acrobatと同じPDFエンジンを利用した開発者向けPDF SDKです。PDF作成、編集、変換だけでなくOCR機能も提供しており、スキャンPDFを検索可能なPDFへ変換できます。
OCR機能を利用することで、
- スキャンPDFのテキスト化
- 検索可能PDFの生成
- テキスト抽出
- AI向けデータ整備
をシステム内で自動化できます。
Adobe PDF Libraryの詳しい機能についてはこちらをご覧ください。
▶ Adobe PDF Libraryでできること一覧 ―作成・編集・変換・OCR・画像化まで―
OCRは手作業ではなく自動処理が重要
OCRという言葉を聞くと、
「必要になったら人が実行するもの」
というイメージを持たれることがあります。
しかしAI活用を本格的に進める場合は、それでは十分ではありません。
企業では日々、
- 契約書
- 請求書
- 申請書
- 技術マニュアル
- 業務文書
が新たに追加され続けます。
そのたびに人手でOCRを行う運用では、作業負荷が大きくなり、取りこぼしも発生します。そこで求められるのがOCRの自動処理です。
Adobe PDF LibraryはSDKとして提供されるため、既存の業務システムや文書管理システムへOCR機能を組み込むことができます。
例えば以下のような運用が可能になります。
PDF登録
↓
OCR自動実行
↓
検索可能PDF生成
↓
テキスト抽出
↓
文書検索
↓
生成AIで活用
利用者はOCRの存在を意識することなく、登録した文書を検索できるようになります。また、AIは常に検索可能な最新文書を参照できるため、回答品質の向上も期待できます。
AI活用の成否は「AI」よりも「PDF品質」
生成AIの話題になると、
- ChatGPT
- Copilot
- AIエージェント
- RAG
といった技術に注目が集まります。
もちろんAIそのものも重要ですが、実際の現場では「AIが読むためのデータ整備」が成功の鍵を握っています。
例えば、
AIが読めるPDF
- OCR済み
- テキスト抽出可能
- 検索可能
AIが読めないPDF
- スキャン画像のみ
- OCR未実施
- 検索不可
この差は、AIの回答品質へ直接影響します。AI導入の効果を最大化するためには、まずPDFをAIが読める状態へ整備することが欠かせません。
大量のPDF資産をAI活用する第一歩
企業には長年蓄積された膨大なPDF資産があります。しかし、その多くはAIにとって十分活用できる状態ではありません。
だからこそ、
- OCR
- テキスト抽出
- 検索可能化
- 自動処理
が重要になります。
Adobe PDF LibraryのOCR機能を活用することで、スキャンPDFを検索可能な文書へ変換し、AIが活用できる情報資産へと変えることができます。
生成AI活用の成功は、AI導入から始まるのではなく、「AIが読める文書づくり」から始まるのです。
Adobe PDF LibraryでのOCR活用についてはこちらをご覧ください。
▶ Adobe PDF Libraryでできること一覧 ―作成・編集・変換・OCR・画像化まで―
