

Unicode 18.0に収録|800年前の文字とAI解読の可能性
2026年9月に公開されたUnicode 18.0で、12世紀に中国東北部で作られた女真文字が収録されました。Unicodeに入るということは、その文字に世界共通の番号が振られるということです。番号が決まれば、どのパソコンでも同じ字として表示でき、検索したり、ほかの人と文字データをやり取りしたりできるようになります。では、読める人がほとんどいない文字にとって、それはこの先どんな研究につながるのでしょうか。この文字にまつわる小話を交えながら、エンジニアの目線で考えてみます。
絵文字の陰で、女真文字がUnicodeに仲間入り
Unicodeの新しい版が出ると、話題になるのはたいてい新しい絵文字です。でも、2026年9月16日に公開されたUnicode 18.0で、北方ユーラシアの歴史が好きな私がまず探したのは別の項目でした。12世紀に金という王朝で作られた「女真文字」の収録です[1]。
Unicode 18.0では、女真文字に965個の番号が割り当てられました[2]。どんな字が並んでいるかは、Unicodeが公開している[女真文字の符号表(PDF)](https://www.unicode.org/charts/PDF/Unicode-18.0/U180-18E00.pdf)で一覧できます。
女真文字ってどんな文字?
女真文字を作ったのは、中国東北部に金を建てた女真の人々だといわれています。歴史書『金史』によると、1119年、重臣の完顔希尹(ワンヤン・シイン)が、漢字の形にならい、お隣の契丹文字の仕組みを取り入れて字を作ったとあります。完成した字書を見た初代皇帝の阿骨打(アグダ)は、大いに喜んだそうです[3]。
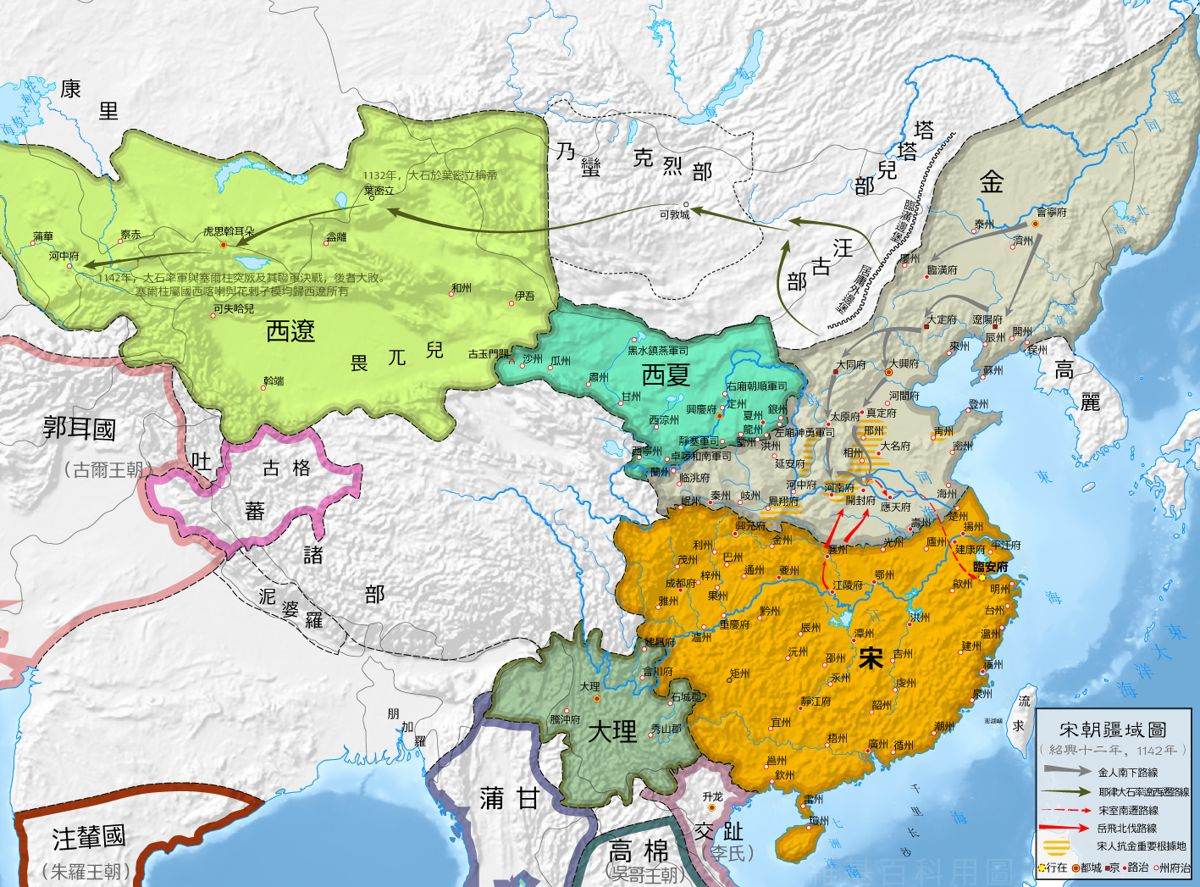
1142年ごろの東アジア。右上の灰色の部分が金です(画像: [玖巧仔](https://commons.wikimedia.org/wiki/File:%E5%8D%97%E5%AE%8B%E7%96%86%E5%9F%9F%E5%9B%BE%EF%BC%88%E7%B9%81%EF%BC%89.png), [CC BY 3.0](https://creativecommons.org/licenses/by/3.0/), via Wikimedia Commons)
同じ『金史』によれば、文字は国の制度にも組み込まれていたようです。1171年には女真人のための官僚登用試験が始まり、のちに論文は女真大字、詩は女真小字で書くよう定められたとされます。1173年の試験では27人が合格したそうです。記録には、試験の夜に寺の塔から音楽のような音が聞こえ、試験官が「優れた人材を得る吉兆だ」と喜んだという話まで残っています[4]。
記録の上では、女真文字には大字と小字の2種類あったことになっています。ところが、今に残る資料の文字はほぼ1種類だけなのだそうです。これが大字なのか小字なのか、研究者の間でもまだ決着がついていないそうです。大字と小字は別々の文字体系ではなく、小字は送り仮名のように大字の読みを補う役割だったという見方もあるそうです[5]。Unicodeでも「女真大字」という名前にする提案が出ましたが、最終的には単に「Jurchen(女真)」という名前に落ち着きました[6][2]。
金は1234年に滅びますが、文字はその後も生き残りました。収録提案の資料によると、1413年に明がアムール川の下流に建てた石碑には、漢文やモンゴル文と並んで女真文字が刻まれているそうです[7]。金の滅亡から数えると、180年近くたってから建てられた石碑です。
解読の大きな手がかりになったのは、明の役所が作った『女真訳語』という単語帳だといいます。女真文字の横に漢字で読みが書かれていて、今でも女真文字の最大の資料とされています[7]。
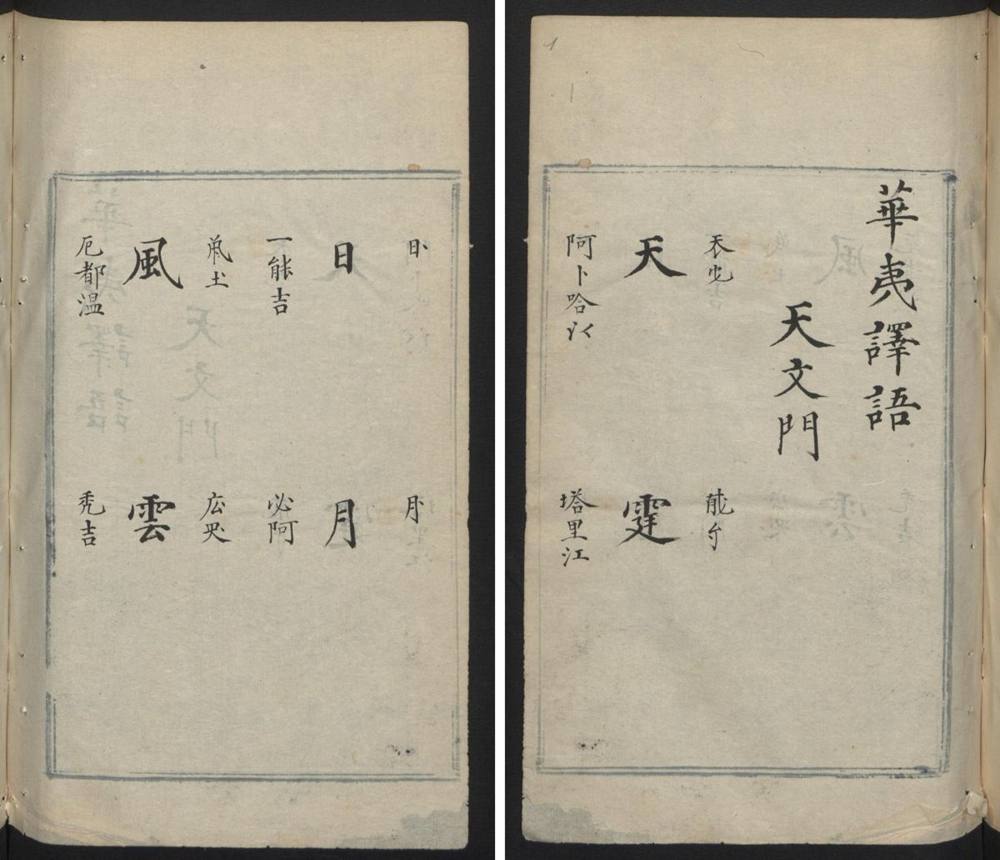
ベルリン国立図書館が所蔵する『女真訳語』の冒頭。大きな漢字が単語の意味で、その右に小さく書かれているのが女真文字、左が漢字で書いた読みです(画像: Staatsbibliothek zu Berlin, Libri sin. Hirth Ms. 1, Public Domain Mark 1.0)
写本の字を、フォントを使って手元のパソコンで表示してみたのが下の図です。写本の見開きに出てくる「天」「月」「風」の3語を選びました。
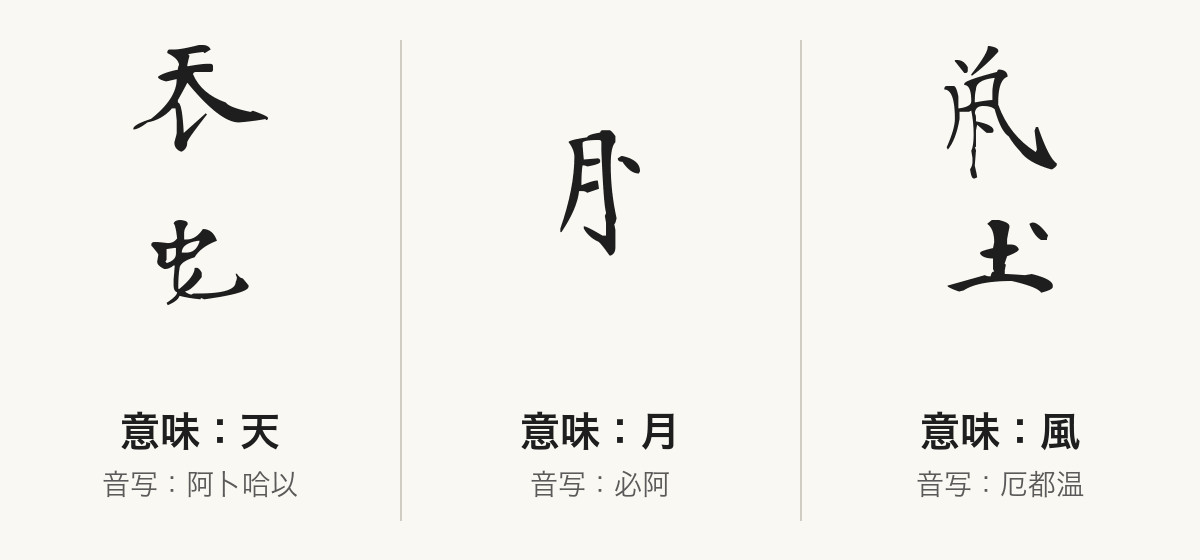
BabelStoneの「Jurchen Berlin」フォントで表示した女真文字。音写は写本に添えられた漢字の読みです。Unicodeの収録提案の字表と照らし合わせると、天はU+18E16とU+18F2E、月はU+190FA、風はU+19177とU+18EC8の字にあたります[7](フォント: [BabelStone](https://www.babelstone.co.uk/Fonts/JurchenScan.html)
一覧表のない文字に番号を振る
番号を振る作業も簡単ではなかったようです。Unicodeの仕様書によると、当時の人が作った「女真文字の全一覧」は残っていないため、石碑や写本に出てくる字を集めて全体を組み立てる必要があったとのことです[8]。2015年に見つかったばかりの石碑から採られた字も含まれています[9]。
最初の収録提案が出たのは2009年です[10]。そこから収録まで17年かかりました。
Unicodeに収録されてきた古代文字
古い文字の収録は、女真文字に限った話ではありません。Unicodeはこれまでにも、古い時代の文字を少しずつ受け入れてきました[11][1]。
- 2003年: 線文字B(古代ギリシアの文字)
- 2006年: 楔形文字(古代メソポタミアの文字)
- 2009年: エジプトのヒエログリフ
- 2016年: 西夏文字(11世紀、中国西北部の文字)
- 2020年: 契丹小字(金の前に北方を治めた遼の文字)
- 2026年: 女真文字
この中にはまだ解読されていない文字も入っています。たとえば2014年に収録された線文字Aは、仕様書の説明では、何語を書いたものかもわかっていないとされています[12]。Unicodeが決めるのは「どれが同じ字で、どれが違う字か」までです。読み方がわからなくても、番号は振れるのです。まだ150以上の文字が順番待ちをしているそうです[13]。
文字コードがないと、何が困るのか
共通の番号がない文字をコンピューターで扱うには、画像のまま扱うか、研究者ごとに独自の番号を決めるしかありません。独自の番号は、ほかの人と共有できなければ広がりません。西夏文字の収録提案には、1971年以来いくつもの方式が考案されたものの、どれも研究者の間に定着しなかったと書かれています[14]。方式がそろっていない文字データは、プログラムにかける前の下ごしらえだけで大仕事になります。
AIが古代文字を読む日は来るのか
古代文字の研究には、AIも使われ始めています。たとえばGoogle DeepMindのIthacaは、欠けたギリシア語の碑文の文字を推測するAIです[15]。
ただし、AIが未解読の文字をすらすら読み解いた例は、まだ見つかりませんでした。目にしたのは、すでに解読済みの文字で手法を試した研究や、未解読の言語に挑んで決定的な結果が出なかった研究でした[16][17]。
ただ、これらの論文には共通点があります。どのAIも、碑文を「文字の並び」というデータにしてから学習していました。共通の番号のない文字では、そのデータを作れません。
地味だけれど、未来につながる一歩
女真文字に番号が振られたからといって、読めなかった字がすぐに読めるようになるわけではありません。けれども、石碑や単語帳の文字を共通のデータとして書き起こし、世界中の研究者やAIが同じ土台の上で扱うための条件は整いました。
契丹文字や女真文字の研究にAIが本格的に使われるのは、まだこれからのようです。だからこそ私は、今回の収録を未来の解読に向けた大切な下準備だと考えています。AIの力も借りて、800年前の文字がもっと読めるようになる日が来るかもしれません。
参考文献
1. Unicode Consortium、「Unicode 18.0.0」、2026. <https://www.unicode.org/versions/Unicode18.0.0/>
2. Unicode Consortium、「Scripts-18.0.0.txt」、2026. <https://www.unicode.org/Public/18.0.0/ucd/Scripts.txt>
3. 脱脱 等、「金史 巻73 列伝第11 完顔希尹」、Wikisource. <https://zh.wikisource.org/wiki/金史/卷73>
4. 脱脱 等、「金史 巻51 志第32 選挙一」、Wikisource. <https://zh.wikisource.org/wiki/金史/卷51>
5. 地球ことば村・世界言語博物館、「世界の文字 女真文字」. <https://www.chikyukotobamura.org/muse/wr_easia_9.html>
6. Viacheslav Zaytsev; Andrew West、「Request to rename Jurchen to Jurchen Large Script (L2/25-171, WG2 N5338)」、Unicode Consortium、2025. <https://www.unicode.org/L2/L2025/25171-rename-jurchen-wg2n5338.pdf>
7. Andrew West; Sun Bojun、「Proposal to Encode the Jurchen Script (L2/24-139, WG2 N5261R)」、Unicode Consortium、2024. <https://www.unicode.org/L2/L2024/24139-n5261r-jurchen-ideographs.pdf>
8. Unicode Consortium、「The Unicode Standard, Version 18.0, Core Specification Chapter 18」、2026. <https://www.unicode.org/versions/Unicode18.0.0/core-spec/chapter-18/>
9. Unicode Consortium、「JurchenSources-18.0.0.txt」、2026. <https://www.unicode.org/Public/18.0.0/ucd/JurchenSources.txt>
10. China NB、「Proposal to Encode Jurchen Characters in UCS (L2/09-164, WG2 N3628)」、Unicode Consortium、2009. <https://www.unicode.org/L2/L2009/09164-n3628-jurchen.pdf>
11. Unicode Consortium、「Supported Scripts」、2026. <https://www.unicode.org/standard/supported.html>
12. Unicode Consortium、「The Unicode Standard, Version 17.0, Core Specification Chapter 8」、2025. <https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-8/>
13. Script Encoding Initiative、「About SEI」、UC Berkeley、2026. <https://sei.berkeley.edu/about/>
14. Richard Cook、「Proposal to encode Tangut characters in UCS Plane 1 (L2/07-143)」、Unicode Consortium、2007. <https://www.unicode.org/L2/L2007/07143-tangut.pdf>
15. Yannis Assael et al.、「Restoring and attributing ancient texts using deep neural networks」、Nature、603巻、280-283頁、2022. <https://doi.org/10.1038/s41586-022-04448-z>
16. Jiaming Luo; Yuan Cao; Regina Barzilay、「Neural Decipherment via Minimum-Cost Flow: From Ugaritic to Linear B」、Association for Computational Linguistics、3146-3155頁、2019. <https://doi.org/10.18653/v1/P19-1303>
17. Jiaming Luo et al.、「Deciphering Undersegmented Ancient Scripts Using Phonetic Prior」、Transactions of the Association for Computational Linguistics、9巻、69-81頁、2021. <https://doi.org/10.1162/tacl_a_00354>
